

| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- 동시성제어
- HWPX문서 자동생성
- 머메이드차트
- 귀찮은거 싫어
- 이미지 빌드 최적화
- 낙관적락
- 캐시
- 자동화
- 서비스 설계
- ci-cd
- k8s
- valkey
- Ai
- pdf입력자동화
- 시퀀스다이어그램
- k3s
- 쿠버네티스
- 교육이수관리
- GitOps
- 인프라
- 처음부터 끝까지 개발해보자 ERP
- 풀스택
- 비관적락
- Redis
- Today
- Total
그린 파인애플님의 블로그
[ERP 구축기 #06] 반복되는 API 호출 줄이기 - Redis와 React Query 캐싱 본문
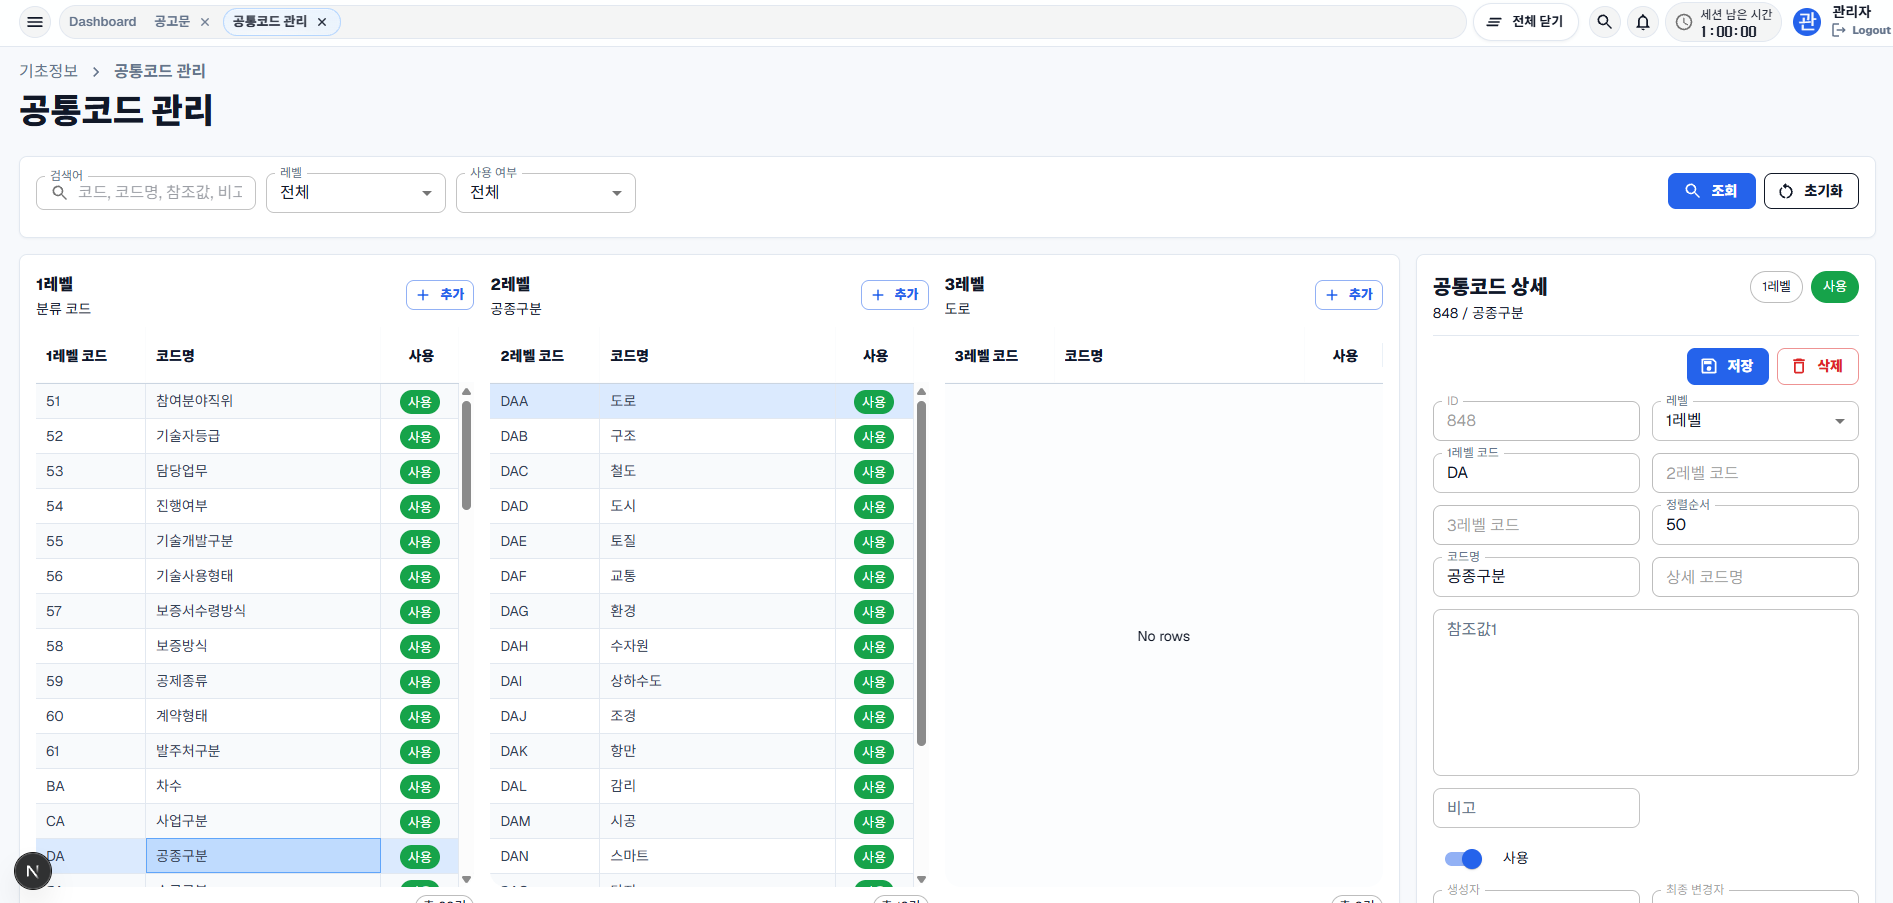
📌 반복해서 조회되는 공통코드
대부분의 ERP 시스템에서는 화면 곳곳에서 공통코드를 사용한다.
직급, 자격구분, 공종구분, 상태값 등과 같은 공통코드는 여러 화면에서 반복적으로 조회되지만 데이터가 자주 변경되지는 않는다.
개발하면서 확인해보니 화면을 이동하거나 새로고침할 때마다 동일한 공통코드를 API를 통해 조회하고 있었고, Backend에서도 매번 PostgreSQL을 조회하고 있었다.
데이터 변경은 적은데 조회는 빈번하기 때문에 공통코드는 캐싱 효과를 보기 좋은 데이터라고 판단했다.
기존에 로그인 세션 관리 용도로 사용하고 있던 Redis가 있었기 때문에 공통코드 조회에도 Redis Cache를 적용해보기로 했다.
| 특징 | 공통코드 |
| 조회 빈도 | 높음 |
| 데이터 변경 | 적음 |
| 여러 화면에서 재사용 | 많음 |
| 데이터 크기 | 작음 |
| 실시간성이 반드시 필요한가? | 상대적으로 낮음 |
조회 빈도가 높고 변경 빈도가 낮은 공통코드부터 캐싱하기로 했다
Redis를 캐시로 사용하면서 가장 먼저 고려한 것은 Redis에 문제가 발생했을 때였다.
공통코드는 시스템 동작에 필요한 데이터이지만 원본 데이터는 PostgreSQL에 있기 때문에 Redis 장애가 전체 서비스 장애로 이어지면 안되기 때문에
Redis 조회가 실패하거나 1초내 응답하지 않는 경우 PostgreSQL에서 데이터를 조회하도록 fallback 로직을 구성했다.
현재 개발 단계에서는 1초를 기준으로 fallback하도록 구현했으며, 실제 운영 환경의 Redis 응답시간을 모니터링한 뒤 timeout 값은 조정할 예정이다.
📚 캐시와 DB 데이터의 정합성 유지
캐싱을 적용하면서 성능보다 더 고민했던 부분은 DB와 Redis의 데이터가 달라지는 문제였다.
예를 들어 관리자가 공통코드를 수정했는데 Redis에는 기존 값이 남아 있다면 사용자는 일정 시간 동안 잘못된 데이터를 보게 된다.
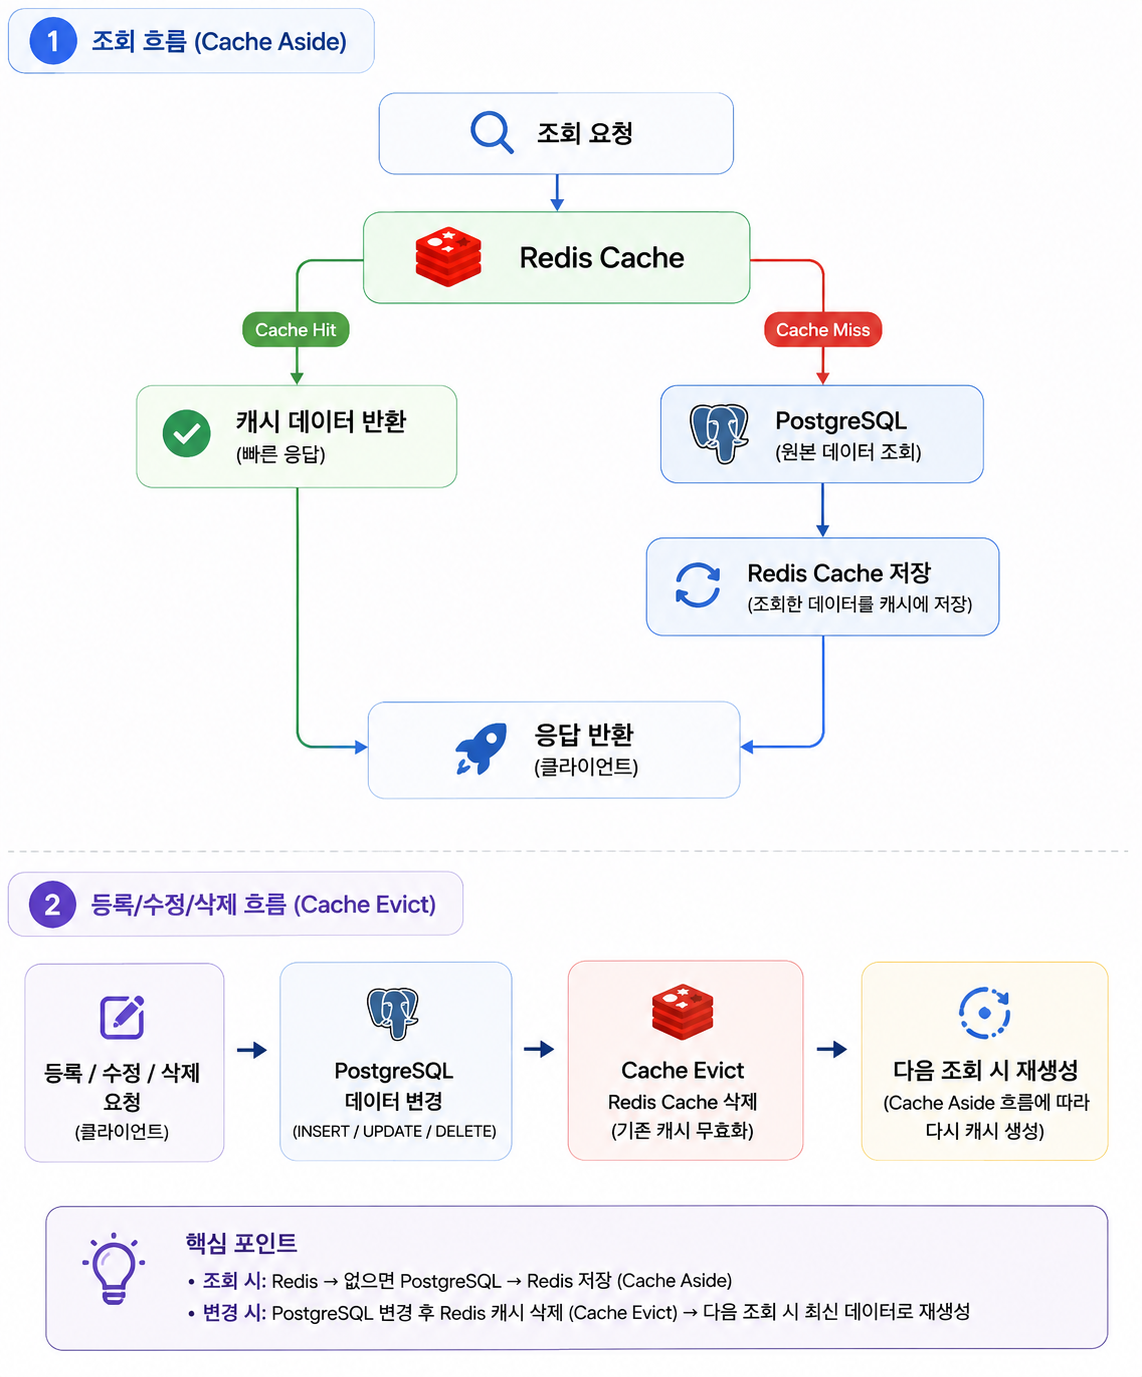
이를 방지하기 위해 공통코드 등록·수정 API가 호출될 경우 PostgreSQL의 데이터를 변경하는 것과 함께 Redis 캐시도 갱신하도록 구성했다.
구글링을 해보니 캐싱을 이용하는 방법이 몇가지가 있었다
| 명칭 | DB 변경 후 Redis 처리 | 캐시 데이터 갱신후 다음 조회 |
| Cache Evict | 캐시 삭제 | DB 조회 후 다시 캐싱 |
| Cache Put | 캐시를 최신 값으로 변경 | 바로 Redis 조회 |
| Cache Aside | 캐시가 없을 때 DB 조회 | DB 결과를 캐싱 |
내부에서만 사용하는 시스템이라 긴급성을 가진 실시간 트래픽이 많지 않았기에
Cache Evict + Aside만 적용하기로 했다
캐시 적용전에는 200ms~400ms 정도 였던 응답시간이 Redis 캐싱 적용후 절반 이상으로 줄었다
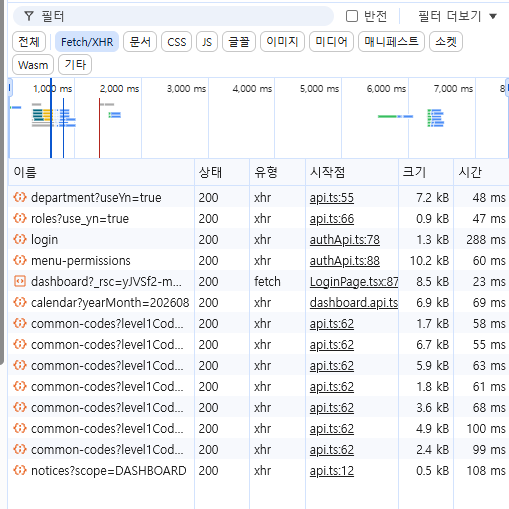

추가적으로 React query를 사용하면서 Cache의 유효시간은 10분으로 설정했다.
공통코드는 변경 빈도가 높지 않기 때문에 우선 10분으로 설정했으며, 운영 이후 코드 변경 빈도와 API 호출량을 모니터링하여 필요하면 조정할 예정이다.
🛠️ Backend뿐 아니라 Frontend에서도 한 번 더 캐싱
| 계층 | 캐시 | 목적 |
| Frontend | React Query | 동일 화면/컴포넌트의 불필요한 요청 방지 |
| Browser | sessionStorage | 새로고침 후에도 일정 시간 데이터 재사용 |
| Backend | Redis | DB 조회 감소 및 API 응답속도 개선 |
| Database | PostgreSQL | 원본 데이터 저장 |
Backend에서 Redis Cache를 적용한 것과 별개로 Frontend에서도 동일한 공통코드 API가 반복적으로 호출되는 것을 줄이고 싶었다.
개발을 하면서 새로고침을 할일이 많았는데 그때마다 네트워크 탭을 보니 매번 API호출을 하고 있었고, 업무 화면 특성상 여러 탭을 띄워서 작업을 하기에 탭이 많은만큼 공통코드 API 도 여러번 호출하고 있었다
React Query를 이용하면 이미 조회한 데이터를 메모리에 캐싱하여 여러 화면에서 동일한 API를 반복해서 호출하는 것을 줄일 수 있다. 하지만 브라우저를 새로고침하면 메모리에 저장된 데이터가 초기화되기 때문에 새로고침 이후에는 다시 API를 호출해야 하는 문제가 있었다.
공통코드는 자주 변경되는 데이터가 아니기 때문에 sessionStorage에도 공통코드와 캐시 시간을 함께 저장하고, 10분 동안은 동일한 공통코드 API를 다시 호출하지 않도록 구성했다.
이렇게 개선하니 브라우저를 새로고침해도 이미 캐싱되어서 브라우저에서 가지고 있는 상태라면 동일한 공통코드를 가져오기 위해 API 호출량을 줄일수 있었고, 10분후, 재로그인하여 화면 진입시 공통코드 API를 다시 호출하여 redis에서 최신화된 데이터를 가져올수 있게 되었다
캐싱을 적용하면서 느낀 점
처음에는 로그인 세션 관리에만 사용하고 있던 Redis를 조금 더 활용해보자는 생각으로 시작했다.
하지만 실제로 적용해보니 단순히 Redis에 데이터를 저장하는 것보다 어떤 데이터를 캐싱할 것인지와 원본 데이터가 변경되었을 때 캐시의 정합성을 어떻게 유지할 것인지가 더 중요했다.
또한 Backend의 Redis Cache만 적용하는 것보다 Frontend에서도 반복적인 API 호출을 줄이면서 전체적인 요청 횟수를 줄일 수 있었다.
앞으로 모든 데이터를 무조건 캐싱하기보다는 조회 빈도는 높고 변경 빈도는 낮은 데이터를 중심으로 캐싱 대상을 검토하고, Grafana 모니터링을 통해 실제 API 호출량과 응답시간을 확인하면서 적용 범위를 조정할 예정이다.
'개발 > [ERP] 풀스택 AI개발' 카테고리의 다른 글
| [ERP 구축기 #08] 엑셀과 전화로 관리하던 기술인 교육관리를 알림 발송으로 자동화하기 (0) | 2026.09.04 |
|---|---|
| [ERP 구축기 #07] 양식이 제각각인 HWPX 문서를 자동 생성해 비용 절감하기 (0) | 2026.09.04 |
| [ERP 구축기 #05] 메뉴 숨김만으로 충분할까? ERP의 RBAC 권한 설계 (0) | 2026.08.28 |
| [ERP 구축기 #04] APM이 없어서 직접 만든 Grafana 모니터링 환경 (0) | 2026.08.26 |
| [ERP 구축기 #03] 현업이 AI로 만든 업무 도구를 ERP 정식 기능으로 발전시키기 (0) | 2026.08.26 |


